2015년 2월 12일 목요일

logstash vs flume vs fluentd

중앙 집중 로깅 시스템

방법론

  • 스크립트로 중앙 서버로 복사하는것
    단순 중앙 저장, 네트워크 에러등 에러 처리 힘듬
  • syslog
    message generation client, message storage system, message report and analysis
    • implementation
    • syslog-ng
    • rsyslog
  • 데이터 량이 많아지고 여러 요구 조건이 나오면서 새로운 디자인이 나옴
    • 이벤트 스트림에 특화됨
    1. 각서버당 로깅 클라이언트를 뛰움
    2. 클라이언트에서 중앙 서버(클러스터 or 어그리게이터)로 로깅을 쏨
    3. 모은 후 분산 그리고 확장 가능한 저장소에 저장(하둡 등)
    • 수평적으로 분산 처리가 되어야함

Apache Flume

  • 언어 : java
  • Run : JVM
하둡을 주 타겟으로 만듬
소스 -> 채널 -> 싱크
  1. 소스
    로깅을 만들어내는주체
  2. 채널(큐)
    로깅을 보내는 곳(버퍼 등의역활)
  3. 저장소(싱크)
    채널에 쌓여 있는 로깅데이터를 순서대로 원하는 저장소에 저

지원하는 소스

  • Avro Source.
  • Thrift Source.
  • Exec Source.
  • NetCat Source.
  • Syslog Sources.

지원하는 싱크

  • HDFS Sink.
  • Logger Sink.
  • Avro Sink.
  • Thrift Sink.
  • File Roll Sink.
  • HBase Sink.
  • ElasticSearch Sink.

장점

  • guarantees data delivery
  • scales horizontally
  • high throughput
  • fault tolerance

Log stash

  • 언어 : JRuby
  • Run : JVM
로그전달자(lumberjack) -> Broker(redis) -> LogStash(indexer) -> Search & Storage
  • 로그전달자
    각 클라이언트에서 생성되는 로그를 중앙 서버로 전송
  • Broker
    중간 또는 분산 처리된 레디스 서버에 로그를 저장
  • LogStash
    Broker 에 싸인 데이터를 처리 해서 처리 후 저장 또는 걍 저장
  • search & storage ( Elasticsearch & Kibana)
    자동화된 툴을 사용해 로그 모니터링 등 (단 다른 애들도 뒤에 붙여 쓸수 있음)

Fluentd

  • 언어 : CRuby
  • Run : vanilla(ruby)
Fluentd(클라이언트) -> Fluentd(컬랙터) -> Storage
  • Fluentd(클라이언트)
    각 클라이언트에서 생성되는 로그를 중앙 서버로 전송
  • Fluentd(컬랙터)
    중간 또는 분산 해서 저장
  • Storage
    컬랙터에서 S3등에 저장

참고

​

2015년 2월 8일 일요일

mongodb Array in array query

mongodb Array in array query

array 안에 array 가 있고 그안의 객체에 array 가 있고 거기에 val 쿼리하기
doc = {
    array1 :[
        [
            {
                array2:[{ key:'val'},{ key:'val'}]
            },
            {}    
        ],
        []
    ]
}

db.doc.find({'array1':{$elemMatch:{$elemMatch:{array2:{$elemMatch:{'key':'val'}}}}}})
​

#서버 시간 동기화

서버 시간 동기화


Network Time Protocol 을 사용해서 시간을 1회 동기화한다.
크론 탭등을 써서 사용하는거 같다
주소
표준시간을 주는 서버를 지정한다.
사용방법
sudo yum install ntpdate
sudo ntpdate time2.kriss.re.kr
​

2015년 2월 7일 토요일

Page rank 머냐 이거 먹는거냐! (1화)

Page rank 머냐 이거 먹는거냐! (1화)


목표

각각의 웹페이지에 점수를 매겨서
검색 사이트에서 특정 단어에 대한 검색을 할 경우 웹페이지의 점수가 높은 애부터 나열하자
ex) 네이버에서 검색을 하면 신뢰성있고 연관성있는 결과물이 상위에 노출된다.

기본 아이디어

  • 모든 웹페이지는 링크로 연결되어 있다고 가정할수있다.
  • 링크는 들어오는 링크(in link) 와 나가는 링크로(out link) 분리할수있다.
  • 더 중요한 페이지는 많은 웹페이지가 가리키고 있을것이다.
    alt text
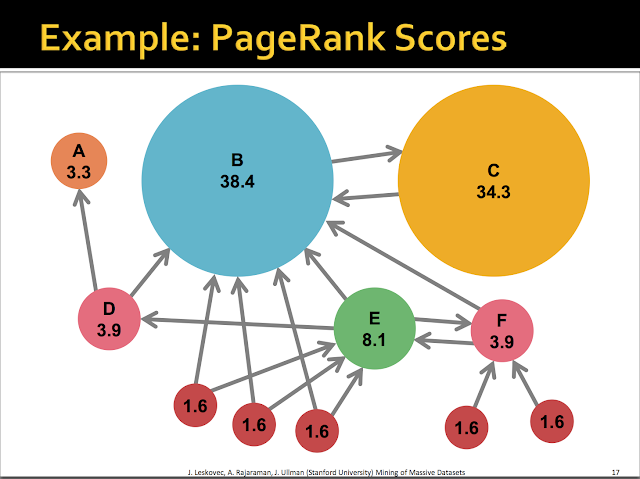
    위 그림(1)을 보면 각각의 페이지들 있고 페이지들은 링크로 연결되어있다.
  • 총 페이지 점수의 합은 100이다.
  • 많은 링크를 받을 수록 높은 점수를 같는다.
  • 높은 점수의 페이지가 가리키는 페이지는 높은 점수를 같는다.
    C는 한개의 in link를 가지고 있지만 B가 점수가 높기 때문에 높은 점수를 같는다.

점수를 어떻게 계산해야 할까?(재귀식)

alt text
위 그림(2)을 보면 j 페이지의 점수를 계산하는 방법이 나와있다
  1. j 페이지는 i, k 페이지에서 링크를 받고 있고 두개의 페이지 점수/out link수 를 기반으로 매겨진다.
  2. j 페이지는 3개의 out link를 가지고 있고 각각의 링크의 점수는 j/3 이다.
위의 식을 보면 재귀적으로 각 페이지의 점수가 매겨지는걸 알수있다.
공식으로 하면 아래와 같다.
r_j = \frac{r_i}{3} + \frac{r_k}{4}
i 페이지는 3개의 out link를 가지고 있다.
k 페이지는 4개의 out link를 가지고 있다.
위식을 좀더 추상화하면 아래의 식을 얻을수있다.
r_j = \sum_{i \to j} \frac{r_i}{d_i}
1번식
j 페이지의 점수는 j로 들어오는 out link 들의 합이다.
out link 점수는 원페이지(i) 점수 / 원페이지의 out link 수

흐르는 모델 (Flow model)

  • 중요한 페이지의 out link 점수는 더 높다.
  • 그러므로 중요한 페이지에게 out link 를 받은 페이지의 점수는 높다
alt text
위 그림(3) 을 보자
위그림의 우측 상단의 그림은 웹이 3개의 사이트로 이루어져 있다고 가정한다.
그럼 실제로 페이지 랭크를 구해보자!
1번 식을 적용하면 아래의 점수를 구할수 있다.
r_y = r_y/2 + r_a/3
r_a = r_y/2 + r_m
r_m = r_a/2
우리는 3개의 미지수와 3개의 공식있다. 풀면된다.
하지만 비례식이므로 답이 여러개다 그러니
r_y + r_a + r_m = 1
아래의 조건을 추가하자
그럼 답은
r_y = 2/5
r_a = 2/5
r_m = 1/5
과 같다

page rank 2화 실적에 적용해 볼까나?


​

R 기본 그래프

Base Plotting System

Plotting System

  • base
    헌번에 한개씩 점진적으로 만들어나간다
  • lattice
    자동화가 되어 있어 한번의 펑션콜로 만들어진다
  • ggplot2
    위 두개의 중간 버전 정도 라고 생각하면된다.
  • 3개 중 하나만 골라써야한다.

Base Graphics

  • 플랏을 만들고
  • 이미 존재하는 플랏에 필요한부분을 추가한다.
ex)
plot(x, y)
hist(x)
파라미터가 많고 파라미터의 도움말은 ?파라미터명 으로 볼수있다.

Histogram

library(datasets)
hist(airquality$Ozone)

Scatterplot

library(datasets)
with(airquality, plot(Wind, Ozone))

Boxplot

library(datasets)
#airquality <- transform(airquality, Month = factor(Month))
boxplot(Ozone ~ Month, airquality, xlab = "Month", ylab = "Ozone (ppb)")

중요한 파라미터들

  • par()
    그래픽에 전채적으로 적용되는 파라미터에 대한 설명
    par(“lty”) $ solid
    par(“col”) $ 5.1, 4.1, 4.1, 2.1
    par(“pch”) $11
  • pch
    심볼(기본은 열린 원)
  • lty
    라인 종류(기본 긴줄) etc 점줄 등
  • col
    심볼 색갈 color()를 하면 색 백터를 돌려줌
  • xlab
    x 레이블
  • ylab
    y 레이블
  • las
    레이블들의 방향
  • bg
    배경색깔
  • mar
    마진사이즈
  • oma
    바깥 마진 사이즈(outer margin size) (기본 : 0)
  • mfrow
    number of plots per row, column (plots are filled row-wise)
    multiple plot 을 로우 먼저 채워라
  • mfcol
    number of plots per row, column (plots are filled column-wise)
    multiple plot 을 컬 먼저 채워라

기본 Plotting functions

  • plot
    make scatterplot or other type of plot
  • lines
    n의 점을 잊는 라인을 그린다.
  • points
    플랏에 포인트를 더한다.
  • text
    특정 x,y 좌표에 텍스트를 더한다.(inside plot)
  • title
    x,y labels, title, subtitle, outer margin 등에 주석을 더한다.(out side plot)
  • mtext
    margins(outer or inner)에 쪽에 텍스트를 더한다.
  • axis
    axis 에 ticks/labels 을 더한다.
library(datasets)
with(airquality, plot(Wind, Ozone))
title(main = "Ozone and Wind in New York City")

with(airquality, plot(Wind, Ozone, main = "Ozone and Wind in New York City"))
#add point at above plot
with(subset(airquality, Month == 5), points(Wind, Ozone, col = "blue"))
library(datasets)
#type = n 데이터를 plot에 그리지 말아라
with(airquality, plot(Wind, Ozone, main = "Ozone and Wind in New York City", type = "n"))
with(subset(airquality, Month == 5), points(Wind, Ozone, col = "blue"))
with(subset(airquality, Month != 5), points(Wind, Ozone, col = "red"))
legend("topright", pch = 1, col = c("blue", "red"), legend = c("May", "Other Months"))

기본 선형 회귀 함수 그리기

library(datasets)
with(airquality, plot(Wind, Ozone, main = "Ozone and Wind in New York City", pch = 20))
model <- lm(Ozone ~ Wind, airquality)
#abline 회귀 라인의 슬로프를 보고 펑션에 그린다. lwd 라인 두께
abline(model, lwd = 2)

여러 plot 한번에 뛰우기

library(datasets)
#mflow = multi plot row
par(mfrow = c(1,2))
with(airquality, {
    plot(Wind, Ozone, main = "Ozone and Wind")
    plot(Solar.R, Ozone, main = "Ozone and Solar Radiation")
})
library(datasets)
#mar = margin oma = outer margin
par(mfrow = c(1,3), mar = c (4,4,2,1), oma = c(0, 0, 2, 0))
with(airquality, {
    plot(Wind, Ozone, main = "Ozone and Wind")
    plot(Solar.R, Ozone, main = "Ozone and Solar Radiation")
    plot(Temp, Ozone, main = "Ozone and Temperature")
    #add text at the margin space
    mtext("Ozone And Weather in New York City", outer = TRUE)
})

정리

  • 일단 플랏을 뛰운다.
  • 필요한 요소를 추가한다.
  • 자유롭기는 하지만 설정할게 너무 많다.
​

2015년 2월 5일 목요일

로깅과 함께 프로세스 시작

로깅과 함께 프로세스 시작

서버에 장시간 프로세스를 뛰어야 할 경우

vi executeWithTime.sh
chmode +x executeWithTime.sh
executeWithTime.sh
executeWithTime.sh 내용
#!/bin/bash

node ./imgUpdater.js  2>&1 | while IFS= read -r line; do echo "$(date) $line"; done >> ./test.log

설명

#!/bin/bash
배쉬를 인터프리터로 쓸거임
node ./imgUpdater.js 2>&1
2>&1 표준 에러를 표준 출력과 같은곳으로 설정
while IFS= read -r line; do echo “$(date) $line”; done
it’s a trick to prevent read from trimming whitespace at the beginning and and of the line. It sets IFS (bash’s Internal Field Separator, basically a list of whitespace characters) to empty for the read command. – Gordon Davisson
>> ./test.log
test.log 에 어팬드 하겠음
​

Centos kernallog

Centos kernallog

로그 config 위치

/etc/rsyslog.conf
설정별 중요한 로그 위치
# Log anything (except mail) of level info or higher.
# Don't log private authentication messages!
*.info;mail.none;authpriv.none;cron.none                /var/log/messages

# The authpriv file has restricted access.
authpriv.*                                              /var/log/secure

# Log all the mail messages in one place.
mail.*                                                  -/var/log/maillog

# Log cron stuff
cron.*                                                  /var/log/cron

# Everybody gets emergency messages
*.emerg                                                 *

# Save news errors of level crit and higher in a special file.
uucp,news.crit                                          /var/log/spooler

# Save boot messages also to boot.log
local7.*                                                /var/log/boot.log
​

2015년 2월 4일 수요일

노드에서 env 설정하기

노드에서 env 설정하기


실제 노드로 개발을 하게 되면 보통
server mode 를 만들게 되는대
  • production
  • production_test
  • test
  • dev
등으로 config를 잡게된다.
쉘스크립트에 넣어 쓰거나 쉘변수로 지정해
사용하는대 필요할 경우
아래와 같은 방법으로 줄수 있다
NODE_ENV=production node server.js
​

몽고디비 오브젝트 사이즈

몽고디비 오브젝트 사이즈

평균사이즈 구하기
var tot = 0;
var cnt = 0;
db.spot.find().forEach(function(obj) {
    var curr = Object.bsonsize(obj); 
    tot += curr;
    cnt += 1;    
})
var objSizeByBite = tot / cnt;
var objSizeByMega = objSizeByBite / (1024 * 1024);
print(objSizeByMega)
주의
Object.bsonsize(db.find({_id:’A’})); 하면 안된다 커서 크기를 측정하는 같다.
Object.bsonsize(db.findOne({_id:’A’})); 해야 된다.
​

2015년 2월 2일 월요일

node 비동기 while 방식 control flow 를 처리

node 비동기 while 방식 control flow 를 처리

개요

node 로 프로그래밍 할경우 가끔 while 방식의 control flow 를 처리해야 하는 경우가 있다
문제는 node 에서는 next()로 밀어 버리기때문에 일반적인 while 방식으로 처리할수 없다는 것이다.
해서 recursive 구조를 사용할 경우 call stack error 때문에 시도 할 수 없는 경우가 많다.
하지만 아래과 같은 방식으로 처리 가능하다.

코드

function isProcessNextJob(callback){
  #db query or some other conditions
  #db.find(function(){
  #  if(spots.length){
  #   return callback(true);
  #  }else{
  #   return callback(false);
  #  }
  #})

  return callback(true);
}

function doRecursiveWork(){
  isProcessNextJob(function(result){
    console.log(result)
    if(result == false){
        return;
    }else{
      setTimeout(doRecursiveWork,0);
    }
  });
}

doRecursiveWork();

한계

물론 위의 문장도 한계가 있다 일단 this 키워드를 사용할수 없으며
call stack 을 새로 만들기 때문에 scope chain 을 사용할수 없다.
하지만 while 방식의 control flow 일 경우 위의 모든것을 감수 하고도 사용 할만한
하나의 대용쯤은 될수 있을 거 같다.

추가내용

settimeout 은 javascript engine 의 event loop 에 새로운 message 를 추가하는 방식으로 작동한다.
*일반적인 함수 호출은 스택위에 싸이는 방식으로 작동
​

2015년 1월 29일 목요일

R pivot, R group by order

#R pivot, R group by order

#Grouping 해서 order 한후 원하는 rank뽑아 내기

#문제 x 를 Group으로 그룹핑한 후 각 그룹에 Quantity별로 해당 랭크를 뽑아 나열해라
#  Group Name Quantity
#1     A    v        3
#2     A    u        3
#3     A    w        4
#4     A    x        5
#5     C    x        2
#6     C    y        0

#각 그룹별 2위는?
#답
#  Group Name Quantity
#A     A    w        4
#C     C    y        0

#function is copyed from
#http://stackoverflow.com/questions/14421338/how-do-i-create-order-statistics-by-group-in-r
#author Matthew Plourde

x <- data.frame(Group=c("A","A", "A", "A", "C", "C"),
                Name=c("v", "u", "w","x", "x", "y"),
                Quantity=c(3,3,4,5,2,0))
#  Group Name Quantity
#1     A    v        3
#2     A    u        3
#3     A    w        4
#4     A    x        5
#5     C    x        2
#6     C    y        0

order(x$Quantity, -rank(x$Name))
#[1] 6 5 1 2 3 4
#tail로 뒷 순위에서 부터 랭킹을 가져옴으로 asc로 정렬
in.order <-  function(group) with(group, group[order(Quantity, -rank(Name)), ])
in.order(x)
#  Group Name Quantity
#6     C    y        0
#5     C    x        2
#1     A    v        3
#2     A    u        3
#3     A    w        4
#4     A    x        5

#그냥 적용할 경우 그룹별 랭킹이 나옴
groups.row <- by(x, x$Group, function(group) in.order(group))
groups.row
#x$Group: A
#  Group Name Quantity
#1     A    v        3
#2     A    u        3
#3     A    w        4
#4     A    x        5
#----------------------
#x$Group: C
#  Group Name Quantity
#6     C    y        0
#5     C    x        2

# select 2등
head(tail(groups.row$A,2),1)
#Group Name Quantity
#3     A    w        4

#해당 tail -> head 를 적용
N <- 2
groups.row <- by(x, x$Group, function(group) head(tail(in.order(group),N),1))
#x$Group: A
#  Group Name Quantity
#3     A    w        4
#-----------------------
#x$Group: C
#  Group Name Quantity
#6     C    y        0

#그룹별 랭킹을 하나의 데이터프래임으로 묶기
#rbind(groups.row$A,groups.row$C)
do.call(rbind, groups.row)
#  Group Name Quantity
#A     A    w        4
#C     C    y        0

2015년 1월 27일 화요일

ssh 서버연결

안될때 디버깅 방법
https://help.ubuntu.com/community/SSH/OpenSSH/Keys
서버쪽
sudo service sshd stop
sudo /usr/sbin/sshd -d
클라쪽
ssh -v ( or -vv) username@host's

ssl 접속
로컬
cd ~/.ssh
ssh-keygen -t rsa -C "resoliwan@gmail.com"
vi id_rsa.pub

복사

서버 접속
cd ~/.ssh
authorized_keys 있으면
cp authorized_keys back_up_authorized_keys
authorized_keys 없으면
cat id_rsa.pub >> authorized_keys
chmod go-w ~/
chmod 700 ~/.ssh
chmod 600 ~/.ssh/authorized_keys

vi authorized_keys 또는 cat id_rsa.pub >> authorized_keys
위에 펍키 그냥 추가하기

authorized_keys 권한이 아래와 같은지 확인
-rw------- 1 usreId usreId 1247 2015-01-28 14:18 authorized_keys

.ssh/config
아래와 같이 설정을 추가해서 쓸수 있음
Host ipaddress
HostName ipaddress
User usreId
identityFile ~/.ssh/self


ssh 서버 설정하기(리무트)
[서버에서]
/etc/ssh/sshd_config
HostKey /etc/ssh/ssh_host_rsa_key
HostKey /etc/ssh/ssh_host_dsa_key


RSAAuthentication yes
PubkeyAuthentication yes
AuthorizedKeysFile      .ssh/authorized_keys
//RSAAuthentication, PubkeyAuthentication을 허용하며  각 유저의 .ssh/authorized_keys 파일에
공개키를 저장하겠음

PasswordAuthentication yes
위에 실패할경우 패스워드 접속을 하겠음

* 옵션별 상세 설명
HostKey /etc/ssh/ssh_host_rsa_key
HostKey /etc/ssh/ssh_host_dsa_key
설명
Specifies a file containing a private host key used by SSH.  The
    default is /etc/ssh/ssh_host_key for protocol version 1, and
    /etc/ssh/ssh_host_dsa_key, /etc/ssh/ssh_host_ecdsa_key,
    /etc/ssh/ssh_host_ed25519_key and /etc/ssh/ssh_host_rsa_key for
    protocol version 2.

    사용이유
   To prevent man-in-the-middle attacks, each SSH server has a unique identifying code, called a host key. These keys prevent a server
   from forging another server’s key. If you connect to a server for the first time or if the server presets a different key then
   previously, WinSCP will prompt you to verify the key.

RSAAuthentication yes
RSA 인증을 설정. Protocol 1 에 적용

PubkeyAuthentication yes
공개키 인증 설정. Protocol 2에 적용

AuthorizedKeysFile
공개키 파일명 파일명을 지정
디폴트는 유저의 홈 디렉토리로부터의 상대 패스에서 AuthorizedKeysFile 에 설정되 있는 파일을 공개키 파일로 설

서비스 재시작
service sshd restart

로컬에서 키생성
[로컬에서]
ssh-keygen -t dsa
Enter file in which to save the key (/Users/lee/.ssh/id_dsa):  enter
이름을 지정하면 키 복사시 ssh-copy-id -i path/to/key_name.pub user_name@host_name
연결시 ssh -i path/to/key_name user@host
로 접속 해야 한다.


키 파일 서버에 올리기
[로컬에서]
scp -P 포트 로컬파일 리무트계정@리무트주소:리무트파일

어떻게 동작하는지 알고 싶으면 아래 링크 확인
http://www.parkjonghyuk.net/lecture/modernCrypto/lecturenote/chap05.pdf

2015년 1월 6일 화요일

genetic algorithm

genetic algorithm
  글로벌 또는 로컬 최적점을 찾기 위해 사용하는 알고리즘

자연선택설에서 아이디어를 빌려온 알고리즘
  생물이 환경에 적합하면 살아남아 서로의 유전 형질을 이어 받은 자식을 남긴다.
  또한 가끔씩 돌연변이가 발생한다.

  세대가 지나감에 따라 자연선택설에 의해 환경에서 가장 적합한 자식이 살아남든다.
  이 자식이 가장 글로벌 최적값에 가깝다 라는 가정

  예를 들어보자
  한종의 여러 객체들이 존재한다. 그리고 특징을 각인덱스의 숫자라고 할때
  s1, s2.... sn
  [1,2,3,5,6,8],[4,5,6,7,8,9]....
  생물이 환경에 적합성을 평가하는 공식 을 e()라고 하자(적합할수록 높은 점수)
  각 객체들을 e(s1)에 집어 넣은 후 정렬하여 탑 10을뽑는다.

  이후 살아남은 객체 들중 교배
    [1,2,3,5,6,8],[4,5,6,7,8,9] -> [1,2,3,7,8,9]= 부모1 중 앞에꺼 3개  부모2중 뒤에꺼 3개
  확률에 의해서 가끔 돌연변이
    [1,2,3,5,6,8] -> [0,2,3,5,6,8] 맨앞의 특성이 조금 변화함
  이가 발생하고 세대가 지나가면

  위를 계속반복함
  세대가 지나감에 따라 가장 환경에 적합한 객체만 생존한다.


def geneticoptimize(domain,costf,popsize=50,step=1, mutprod=0.2,elite=0.2,maxiter=100):
  # Mutation Operation
  def mutate(vec):
    i=random.randint(0,len(domain)-1)
    if random.random()<0.5 and vec[i]>domain[i][0]:
      return vec[0:i]+[vec[i]-step]+vec[i+1:]
    elif vec[i]<domain[i][1]:
      return vec[0:i]+[vec[i]+step]+vec[i+1:]

  # Crossover Operation
  def crossover(r1,r2):
    i=random.randint(1,len(domain)-2)
    return r1[0:i]+r2[i:]

  # Build the initial population
  pop=[]
  for i in range(popsize):
    vec=[random.randint(domain[i][0],domain[i][1])
          for i in range(len(domain))]
    pop.append(vec)
  # How many winners from each generation?
  topelite=int(elite*popsize)
  # Main loop
  for i in range(maxiter):
    scores=[(costf(v),v) for v in pop] scores.sort( )
    ranked=[v for (s,v) in scores]
    # Start with the pure winners
    pop=ranked[0:topelite]
    # Add mutated and bred forms of the winners
    while len(pop)<popsize:
    if random.random()<mutprob:
      # Mutation
      c=random.randint(0,topelite)
      pop.append(mutate(ranked[c]))
    else:
      # Crossover
      c1=random.randint(0,topelite)
      c2=random.randint(0,topelite)
      pop.append(crossover(ranked[c1],ranked[c2]))
    # Print current best score
    print scores[0][0]
  return scores[0][1]

Simulated Annealing

Simulated Annealing
로컬 최적점을 피하기위해 사용하는 최적점 휴레스틱 알고리즘

주어진 시간에(자원에) 최선을 다한 글로발 최적점을 찾기위해 사용
(정획히 글로발 최적점을 찾기위해 모든 가능성을 계산하는게 아니라 주어진 자원만큼만 계산함)

컨셉 :철을 강화하기 위해 열을 높이고 식이는 담금질 기법에서 아이디어를 차용함
temp라는 온도 변수 높은 값에서 --> 낮은값으로
s (현재파라미터), s'(비교파라미터), E() 결과 함수

기본적으로 현재값 E(s)보다 비교값 E(s')이 작을때 비교파라미터 s' 을 현재 파라미터로 s 로 변경하나
로컬 최적점을 피하기 위해서 확률을 사용해 반대의 경우에도 변경하는경우가 있다(T가 높을때 반대의 경유로 변경하는일이 자주 발생)

동작방법

while temp > 0
if(E(s') < E(s)) prob =  1
else prob = exp(-(E(s')-E(s))/T)

if(random.float() < prob) s = s'

temp--;

return s

위 함수를 보면 temp 가 0이될때까지 계산한다(주어진 자산만큼)
E(s') < E(s) 이면 prob = 1
만약 비교 파라미터가 이전 파라미터보다 크면 무조건 비교 파라미터로 변경
그렇지 않다면 exp(-(E(s')-E(s))/T)
비교 값이 현재 값보다 작기 때문에 크기 때문에 -(E(s')-E(s)) 은 무조건 양수
최초 T 가 크면 exp(0)에가까워지고 확률은 1이 나올 가능 성이 높아진다.
(현재값보다 비교값이 크지만 로컬 옵티마를 피하기 위해 변경 하는 경우)
하지만 T 가 작아질수록 1에 비해 상대적으로 작은 값이 나올 확률이 점점 높아 진다


2014년 12월 12일 금요일

lattax mac 설치

texmaker의 장점은 바로바로 이쁘게 볼수 있다 강추한다.

1.http://wiki.ktug.org/wiki/wiki.php/MacOSInstall
2.texmaker
  preference
  pdfLatTax "/usr/local/texlive/2014/bin/universal-darwin/pdflatex" -synctex=1 -interaction=nonstopmode %.tex
  check pdf built in viewer

3.한글을 쓰려면 1번을 한후에 아래처럼 패키지를 불러온다.
  \documentclass[11pt]{article}
  \usepackage{kotex}