레이블이 algorithm인 게시물을 표시합니다. 모든 게시물 표시

2015년 4월 6일 월요일

Recommander System

Recommander System


  1. Collaborative Filtering
    x가 피쳐 백터
    \Theta가 유저별 liner regression 파라미터 백터라고 할때
    x^{(1)},\dots,x^{(n_{m})}을 주면 \Theta^{(1)},\dots,\Theta^{(n_{u})} 을 구할수있다.
    \min\limits_{\Theta^{(1)},...,\Theta^{(n_{u})}}\frac{1}{2}\sum_{j=1}^{n_{u}}\sum_{i:r(i,j)=1}((\Theta^{(j)})^{T}x^{(i)} - y^{(i,j)})^2 + \frac{\lambda }{2}\sum_{j=1}^{n_{u}}\sum_{k=1}^{n}(\Theta^{(j)}_{k})^2
    반대로 \Theta^{(1)},\dots,\Theta^{(n_{u})} 을 주면 x^{(1)},\dots,x^{(n_{m})} 을 구할수있다.
    \min\limits_{x^{(1)},...,x^{(n_{m})}}\frac{1}{2}\sum_{i=1}^{n_{m}}\sum_{j:r(i,j)=1}((\Theta^{(j)})^{T}x^{(i)} - y^{(i,j)})^2 + \frac{\lambda }{2}\sum_{i=1}^{n_{m}}\sum_{k=1}^{n}(x^{(j)}_{k})^2
    결국 닭이 먼저냐 달걀이 먼저냐 라는 생각이 든다. 하지만 우리는 유저가 각 영화에 점수를 매긴 값을 가지고 있다 어떻게 보면 x 와 세타는 유저별 영화평점에서 파생된 점수 들이라는 관점에서 볼수있다.
    그렇다면 세타와 x를 랜덤벨류로 주고 gradient descendent를 돌린다면? 둘다 구할수 있다 여기서 우리는 아래의 cost function 을 얻을수 있다
    J(x^{(1)},...,x^{(n_{m})},\Theta^{(1)},\dots,\Theta^{(n_{u})}) = \frac{1}{2}\sum_{(i,j):r(i,j)=1}((\Theta^{(j)})^{T}x^{(i)} - y^{(i,j)})^2 + \frac{\lambda }{2}\sum_{i=1}^{n_{m}}\sum_{k=1}^{n}(x^{(j)}_{k})^2 + \frac{\lambda }{2}\sum_{j=1}^{n_{u}}\sum_{k=1}^{n}(\Theta^{(j)}_{k})^2
    위의 펑션을 cost funciton으로 하고 아래의 코스트 펑션의 미분 식 으로 파라미터 값을 동시에 갱신하면 된다.
    \frac{\partial J}{\partial x^{(i)}_{k}} = \sum_{j:r(i,j)=1}((\Theta^{(j)})^{T}x^{(i)} - y^{(i,j)})\Theta^{(j)}_{k}  + \lambda x^{(i)}_{k}
    \frac{\partial J}{\partial \Theta^{(j)}_{k}} = \sum_{i:r(i,j)=1}((\Theta^{(j)})^{T}x^{(i)} - y^{(i,j)})x^{(i)}_{k}  + \lambda \Theta^{(j)}_{k}
    이렇게 우리는 피쳐백터 x 와 각 유저별 파라미터 벡터를 얻을수 있기 때문에 해당 유저가 평점을 매기지 않은 점수도 예측할수 있게 된다.
    하지만 위의 식에서 평점을 0~5 라고 할때 평점을 매기지 않은 점수를 0으로 가정해서 알고리즘을 적용하면 문제가 발생할 요지가 있다.
    유저가 평가를 안했으면 0점이 아니라 평균 점수를 주는게 맞기 때문이다.
    그래서 우리는 평점을 nomaliztion 해서 사용할경우 좀더 좋은 결과를 얻을수있다.

2015년 4월 2일 목요일

mmd ch10 Mining Social-Network Graphs

10 Mining Social-Network Graphs

페이스북 친구 관계처럼 그래프로 그려 낼수 있는 데이터는 많다. 우리는 해당 소셜 네트워크에서 커뮤니티를 찾아 내는 방법을 공부할것이다. 해당 알고리즘은 클러스터링과 비슷하게 보일수도 있지만 커뮤니티가 중첩될수 있다는 부분이 다르다. 예를 들어 페이스북 친구들에서 커뮤니티를 찾아낸다면 A는 대학교 커뮤니티면서 A는 고등학교 커뮤니티에 동시에 속할수 있다. 해당 부분에 대해서 공부해보자

  1. 10.1 Social Networks as Graphs
    소셜 네트워크 그래프 모델에 대해서 공부해 보자 소셜 네트워크 특징은 안의 노드들이 동일한 커뮤니티에 속해 있을 경우 클러스터링 되어 있다는것이다.
  2. 10.1.1 What is a Socail Network?
    우리는 페이스북, 트위터 ,구글+ 등을 보고 소셜 네트워크라고 부른다. 즉 사회적인 관계를 표현한 네트워크 란 의미이다. 자 소셜 네트워크 주된 특징은 무엇일까?
    • 네트워크에 참여하는 entities 들이 있으며 대체적으로 사람이다(하지만 다른경우도 있음)
    • entities 사이에 관계가 존재한다. 관계의 종류는 다양하며 페이스북에서는 친구 이며 관계는 친구이거나 아니거나로 표현된다. 하지만 구글+에서는 관계가 숫자로 나타난다. 친구, 가족 등 (예를 들면 두사람이 대화하는 날짜/모든 사람이 평균적으로 대화하는 날짜 같은 비율로 나타난다.)
    • nonrandomness 또는 locality 라는 가정이 존재한다. 관계가 있는 애들은 클러스터링 되어 있을 가능성이 높다라는 가정이다. 예를 들어 A가 B 와 C 에게 연결 관계가 있으면 B 와 C 가 서로 알 가능성이 평균에 비해 훨씬 높다는것이다.
  3. 10.1.2 Social Networks as Graphs
    소셜 네트워크는 그래프를 이용해서 모델링 할수있다. 소셜 그래프라고 불린다.
    엔터티는 노드라고 부르며 에지는 두 노드간의 관계를 표현한다. 만약 엣지에 등급(degree)을 줘야 하면 엣지에 레이블을 붙여서 표현 할수 있다. 소셜 그래프는 방향성이 있을 수도 (twiter followe) 없을 수도 있다. (facebook friend)
    alt text
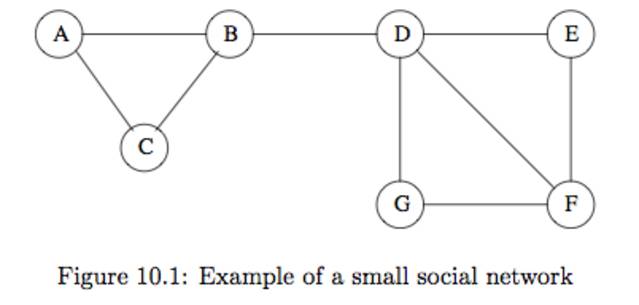
     ex(10.1)
      figure 10.1 은 A~G까지는 사람이고 각 엣지는 친구 관계를 나타낸다. 예를 들면 B는 A,C,D와 친구이다.
    
    위의 그래프에서 locality 를 확인해 보자 9개의 엣지와 7개의 노드가 있다.
    노드간 존재 할수 있는 엣지의 총수는 {7\choose 2} = 21 이다.
    위의 그래프에서 X,Y,Z 를 뽑는다고 생각해보자(예를 들어 X = A, Y = B, Z = C)
    X,Y가 연결되어있고 X,Z가 연결되어 있을떄 Y,Z 가 연결될 확률을 구해보자
    물런 그래프가 엄청크다면 확률을 9/21 = 0.429 일것이다. 하지만 그래프가 작음으로 진짜 확률과 비율의 차이를 볼수 있다. 이미 (X,Y),(X,Z)의 연결이 존재함으로 엣지는 7개 노드는 19 개가 남아있다 즉 (Y,Z)의 확률은 7/19 = 0.368 이라는걸 알수있다.
    하지만 정말로 위의 그래프에 X,Y,Z를 대입해서 구해보자 X가 정해질 경우 Y,Z의 순서는 상관없다.
    X 가 A 라면 B,C 의 노드만 가능하고 두개가 연결되어 있음으로 +1 이라고 하자
    위의 상황은 X가 C,E,G 일때도 동일하다.
    X 가 F 라고 하면 F는 3개의 이웃노드를가지고 있고 (D,E,G) Y, Z가 D,E 또는 D,G일 경우 엣지가 존재한다. 하지만 E,G일 경우 엣지가 존재하지 않는다. +2, -1 이라고 하자
    X 가 B라면 +1 = {(A,C)}, -2 = {(A,D).(C,D)} 가된다.
    X 가 D라면 +2 = {(E,F),(G,F)}, -4 = {(B,G),(B,E),(B,F),(E,G)}가된다.
    위의 모든 수를 계산하면 +9, -7의 경우를 알수있다. 그렇다면 실제 가지고 있을 확률은 9/16 = 0.563이다. 이 확률은 0.368 에 비해 충분이 크다 그러므로 관계가 있는 애들끼리는 다른 애들보다 관계가 있을 확률이 높다는 locality 를 증명한다.

  1. 10.1.3 Varieties of Social Networks
    locality 와 relationships 속성이 있는 다른 종류의 소셜 네트워크를 나열해보자
    • Telephone Networks
      노드는 전화번호이며 특정한 기간에 A 와 B가 전화로 연결되었으면 관계가 있다고 정의하고 그 해당 기간 동안에 연결된 횟수를 degree로 나타낼수 있다.
    • Email Networks
      노드는 이메일이며 두개의 주소가 한번이라도 이멜을 발송(or 수신)한적이 있으면 관계가 있다고 보자(스팸머를 피할려면 수신,발신 둘다 있을때로 정의)또는 한쪽간의 연결관계가 있으면 약함 양쪽도 있으면 강함으로 나타낼수도 있다.
    • Collaboration Networks
      노드는 개인이며 연결과계는 같은 논문을 공동 저자로 나올때 생긴다고 보자 또는 논문을 노드로 보고 두 논문에 같은 저자가 있으면 연결관계를 만든다로 정의 할수도 있다.
      또한 양방향 관계가 있는 경우는 관계를 나타낼수 있다. 예를 들어 위키 피디아의 editior을 노드로 보고 두 editer가 동일한 article을 수정했다면 관계를 맺을수있다.
      ch9에 나오는 유저와 공산물과의 관계도 네트워크로 나타낼수도 있다. 예를 들어 동일한 물건을 산 유저들을 하나의 커뮤니티로 볼 수 있다.
      반대로 동일한 유저들에 의해 구매된 공산물들을 하나의 커뮤니티로 볼수있다.
    • other Examples of Social Graphs
      다른 종류의 많은 현상들도 소셜 그래프로 볼수있다 특히 locality 를 가지고 있다면..
      inforamtion networks(documents, web garph, patents)
      biological networks(genes, proteins, food-web of animal each other)
      product co-puchaing networks

  1. 10.1.4 Graphs With Serveral Node Types
    여러종류의 노드 타입을 같는 현상들이 존재한다.
    우리가 조금전에 이야기한 collaboration networks 의 경우 user 와 proudct의 2가지 노드로 구성되어 있다.
    또한 조금전에 이야기한 논문의 경우 논문, 저자로 표현할수있다.(좀전에는 둘중 하나를 없애서 표현한 경우 이다.)
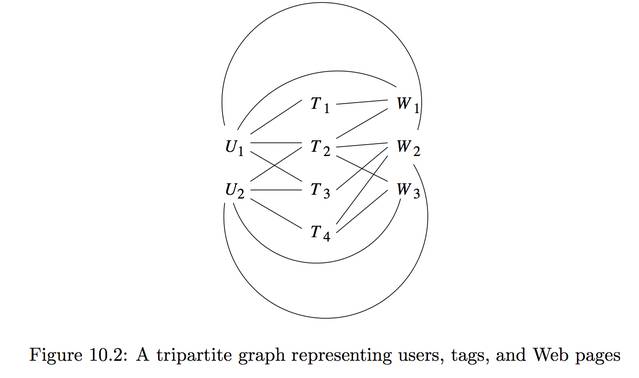
    좀더 복잡한 예를 들자면 유저가 페이지에 주제별로 테깅을 한다고 생각해보자 3개의 종류의 노드가 존재하는경우이다.
    이럴 경우 k-partite 그래프라고 하며 k > 1 보다 크다. k-partite 그래프는 k 의 서로 다른 set 으로 구성되며 같은 set 끼리는 엣지가 없다.
     ex10.2)
     users = {U1,U2}
     tags = {T1,T2,T3,T4}
     webPages = {W1,W2,W3} 가 존재한다고 하고 
     {U1,T2}의경우 user1이 T2를 태깅했다고 생각하자 
     {T2,W2}의 경우 w2 page에 T2태그가 태깅된 것이다.
    
    alt text

  1. 10.2 Clustering of Social-Network Graphs
    소셜 네트워크의 경우 하나의 노드가 여러커뮤니티에 속할 수 있음으로 ch7 에서 이야기한 알고리즘이 잘맞지 않는다.
    (A노드는 고등학교 커뮤니티에 속하면서 대학교 커뮤니티에도 속할수 있다.)

  1. 10.2.1 Distance Measures for Social-Networks Graphs
    일단 클러스터링을 할려면 거리를 측정하는 방법을 정해야 한다 만약 그래프 사이에 degree가 존재하면 해당 정도를 쓸수 있지만 그렇지 않은 그래프가 더 많다 예를 들어 페이스북의 경우 친구이거나 아니거나 이다. 예를 들어 우리가 친구 이면 0 아니면 1이라고 거리를 정한다고 생각해보자 (거리기 때문에 가까울수록 작다) 또는 친구이면 1 아니면 무한대 라고 할 경우 해당 측정은 삼각 거리 ( triangle inequality)측정에 위배 된다. 예를 들면 (A,B)그리고 (B,C)가 친구이고 (A,C)가 친구가 아니라면 A -> C = 1 이고 A -> B -> C 는 0 이된다 삼각거리가 성립될려면 거처서 연결된 점은 바로 연결된 점보다 같거나 커야 된다.

  1. 10.2.2 Applying Standard Clustering Methods
    만약 우리가 일반적인 클러스터링 알고리즘 중 hierarchical 을 사용한다고 가정하면 우리는 거리를 측정 할수 없게 연결된 두 노드중 랜덤으로 뽑아서 결합 할것이다. 그래프가 크가면 결과 또한 랜덤하게 나옴으로 클러스터링 된다고 할 수 없다.
     위의 그림에는 {A,B,C}와 {D,E,G,F}클러스터가 존재한다고 볼수 있다 문제는 어떻게 해당 클러스터를 찾아낼수 있을까이다.
    
    다음으로는 kmean을 사용한다고 가정해보자 k=2 이고 우리가 정말 잘뽑아서 시작점을 B,와 F를 뽑앗다고 하자 D는 어디에 속해야 하는가? 정확이 F에 속한다고 인간은 판단하지만 알고리즘에서는 랜덤하게 됨으로 해당 알고리즘도 사용할수 없다.(D를 제일 마지막에 배치한다고 하고 주변에들과 비교해 가장 가까운 쪽
    에 붙일수 있지만 그래프가 커지면 에러가 생길수 있는 로직이다.)

  1. 10.2.3 Betweenness
    위에서 설명한 문제들을 해결하기 위해 여러 클러스터링 방법론이 만들어졌고 그중 심플한 알고리즘을 소개한다.
    기본 아이디어는 커뮤니티에 속하지 않을 가장 그럴사한 엣지를 찾아내는것이다.
    betweeness 라는걸 엣지 (a,b)사이에 존재하는 모든 노드 쌍x,y의 가장 짧은 거리(shortest path)라고 정의하자
    betweeness가 클수록 해당 엣지를 커뮤니티를 분리하는 엣지로 정의하는 방법이다.(아래에 상세 설명됨)
    참고:Betweenness centrality
  2. 10.2.4 The Girvan-Newman Algorithms
    엣지들의 betweenness 를 계산하기 위해서 우리는 각 엣지들을 지나는 shortest paths 들의 숫자를 새야한다.이방법중 하나인 Girvan-Newman(GN)알고리즘을 소개한다. 우리는 그래프의 모든 노드를 돌면서 해당 노드에서 다른 노드까지의 shortest path를 구할것이다. 해당 알고리즘은 그래프에 BFS(breath-first serach)를 행함으로 시작된다. BFS 표현에서 레벨은 X에서 해당 노드까지 갈수 있는 shortest path의 길이를 의미한다. 그러므로 같은 레벨에 있는 노드들끼리의 엣지는 X를 기준으로 절대 shortest path가 될수 없다.
    레벨사이에 존재하는 엣지들을 DAG 엣지라고 부르자(directed acyclic graph). 모든 DAG 엣지들은 루트 X에서부터 다른 노드들 사이를 가장 잛게 연결하는 shortest path의 일부분이 된다.
    만약 (Y,Z)의 DAG엣지가 존재한다고 가정하자 이떄 Y노드의 레벨이 Z노드보다 루트에 가까운 레벨의 노드라면 Y를 Z의 parent, Z를 Y의 자식 이라고 호칭하자 (부모가 유니크할 필요는 없다.)
    alt text
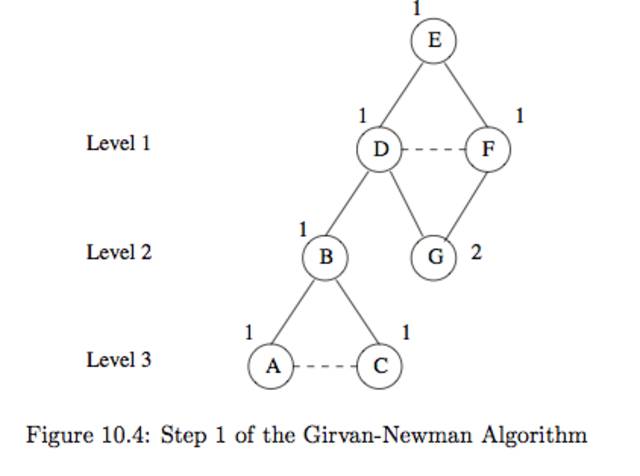
     ex10.6)f10.4를 보면 f10.3을 BFS로 표현한것이다. 루트는 E이다.
     1. 그래프를 BFS로 표현한다.
     2. 루트에 1을 표시하고 트리를 내려가면서 모든 자식 노드들의 점수는 연결된 부모노드의 점수의 합계로 정의한다.
    
     ex10.7)위의 2번째 스탭을 자세이 설명해 보자 
     1. E는 루트임으로  E는 1
     2. D,F의 부모는 E임으로 각각D,F는 1
     3. B의 부모는 D임으로 D는 1, G의 부모는 D,F임으로 합계 G는 2
     4. A,C의 부모는 B임으로 각각 A,C는 1
    
    3번쩨 스탭은 각각의 엣지 e의점수를 계산한다.
    e의 점수 = 루트 X에서 엣지e 를 통해 Y로 가는 모든 shortest path / 루트 X에서 Y로 가는 모든 shortest path
    해당 점수를 계산하는 방법은 아래와 같다.
     1. 모든 DAG 엣지의 leaf노드는 1점을 부여한다.
     2. 리프노드가 아닌 모든 노드들은 해당 노드에 DAG엣지의 합계 + 1을 부여한다.
     3. Z으로 들어오는 엣지e의 점수는 루트에서 Z으로 e를 통해 들어오는 모든 shortest path / Z로 들어오는 모든 shortestpath 이다.
    
    3.1 위의 식을 좀 추상화 하면 Z의 부모를 Y_{1},Y_{2},\dots,Y_{K}라고 할때 p_{i}를 루트로 부터 Y_{i}로 들어오는 shortest path의 수량이라고 하자(fig10.4의 점수)그러면 우리는 엣지(Y_{i},Z)의 점수를 \frac{Z * p_{i}}{\sum_{j=1}^kp_{j}}라고 할수 있다 위식의 Z는 위의 2번 규칙에 때라 각 노드에 부여한 점수이다.
    alt text
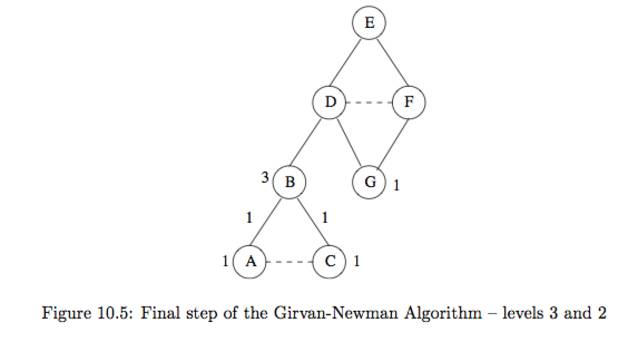
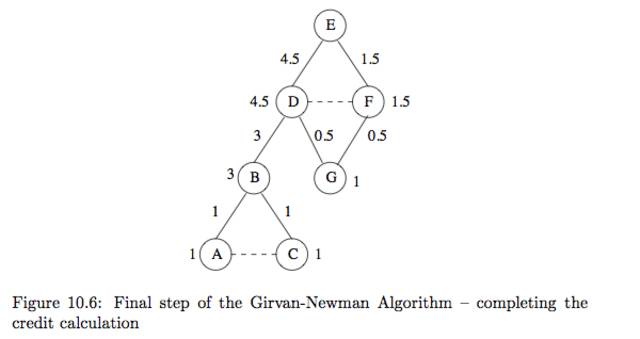
     ex10.8)위의 f10_5를 보자 우리는 맨아래 3레벨에서 부터 계산해 올라갈것이다. 
     1. 3레벨의 A와 C는 리프임으로 1을 같는다.
     2. 각 노드들은 하나의 부모를 같고 있음으로 엣지(B,A),(B,C)에 각각 1점을 부여한다.
     3. 2레벨의 G는 리프임으로 1, B는 리프가 아님으로 자기에게 들어오는 엣지의 합 + 1를 주면 3이된다.
     (B가 3인이유는 B를 통과해 가는 shortest path 가 많기 때문이다.)
     4. 1레벨로 가면 B는 D하나만 부모로 가짐으로 (B,D)는 3이다. G의 경우 (D,G),(F,G)를 가짐으로 점수를 분리한다
     근대 무슨 기준으로 분리해야할까? fig10.3의 D,F가 각각 1점임을 알수 있고(Root E에서 각각,D,F로 갈수 있는 shortest path의 수) 위의 3.1의 식을 적용하면 1*1/1+1 즉 각각 0.5 임을 알수 있다.
     5. 1레벨노드를 계산하면 D는 엣지합(3.5) + 1 = 4.5, Fsms 0.5 + = 1.5임을 알수있다.
    
    alt text
    우리가 모든 노드에 대하여 위의 알고리즘을 돌리면 모든 관계가 2번씩 발견됨으로 2로 나누어 주어야된다.
  3. 10.2.5 Using Betweenness to Find Communities
    betweeness 점수는 그래프에서 각 노드들간의 distance measure 와 비슷하다.(물런 정확히 그렇지는 않다 왜냐하면 연결되지 않은 노드끼리의 점수는 정의 되지 않았기 때문에 또한 정의한다고 해도 triangle inequality를 만족하지 못할것이다.)
    어째든 우리는 betweenness를 증가 하는 순서대로 하나씩 붙임으로써(작은 점수부터) 조금씩 큰 클러스터를 만들수 있다.
    위의 아이디어는 edge removal로 표현될수 있다 그래프를 모든 연결된 엣지에서 시작해 높은 betweeness 엣지를 삭제해 나간다 (만족할 만한 커뮤니티 그룹을 찾을때까지)
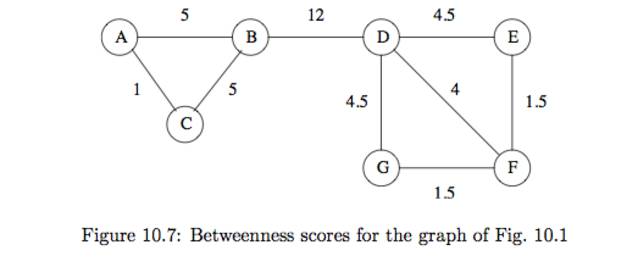
     ex10.9)f10_7을 보면 우리가 구한 betweeneess점수가 모든 엣지에 적혀있다.(아래 점수는 reader기분으로 왼쪽에서 부터 계산된 결과이다 )
    
    alt text
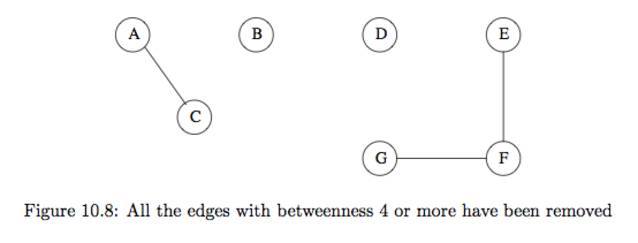
     일단 (B,D)가 가장높은 점수임으로 삭제한다 그러면 {A,B,C}와 {D,E,F,G}로 클러스터링 할수있다. 하지만 우리가 계속 높은 점수대로 제거해 나가면 {A,C},{B},{D},{E,F,G}로 나누어진다.
    
    alt text
    위의 그림은 조금 이상하게 느껴진다. 하지만 {A,C}가 연결되고 B가 분리된 이유는 B가 외부와 연결하는 통로이기 떄문이다.{E,G,F} 와 D도 동일한 맥락에서 이해 할수 있다.

정리중..


원본책  http://www.mmds.org

2015년 3월 31일 화요일

massive mining data ch6 Frequnet Itemsets

6 Frequnet Itemsets

자주 함께 나오는 아이템 셋을 찾아보자 다를 말로하면 연관 룰을 찾는다고 할수도 있다.
이챕터에서 일단 마켓-바구니(items vs basket many to many relations ship) 모델을 소개한다.
우리의 목적은 각각의 바구니에서 동시에 같이 나오는 아이템 셋을 찾는것이다.
3장에서 나온 문제와는 다르다. 3장에서는 비슷한 바구니를 찾는거라면 여기서는 정확이 몇개의 바구니에서 나왔는지 수를 센다.
위의 차이점은 A-Prioir 알고리즘을 소개한다. 해당 알고리즘은 연관 규칙이 성립하기 위해서는 상위의 셋의 모든 서브셋이 frequent 해야 한다는 조건에 기반을 둔다.
그후 해당 알고리즘을 변형시켜 빠른 속도에 추정치를 리턴하는 변형 알고리즘들을 확인한다.

  1. 6.1 The Market-Basket Model?
    market-basket 모델은 전형적인 다대다 관례를 가진 모델이다.
    한쪽은 items 이라고 부르며 반대쪽은 baskets 이라고 한다.
    baskets은 여러개의 아이템으로 구성되 었다.
    또한 우리는 각 바스켓에 포함된 아이템의 수가 적다고 가정한다.
    또한 바스켓 자체는 매우 큰 데이터라고 가정한다.
    • 6.1.1 Definition of frequent Itemsets
      여러 바스켓에 동일한 아이템셋이 여러번 나타나면 우리는 frequent 라고 한다.
      기준을 정하기 위해 아이템셋의 모든 바크셋에서 노출 빈도수가 특정 수 s(support threshold)보다 크다면 해당 itemset을 frequent 라고 정의하자
      ex1)
      1.{Cat, and, dog, bites}
      2.{Yahoo, news, claims, a, cat, mated, with, a, dog, and, produced, viable,
      offspring}
      3.{Cat, killer, likely, is, a, big, dog}
      4.{Professional, free, advice, on, dog, training, puppy, training}
      5.{Cat, and, kitten, training, and, behavior}
      6.{Dog, &, Cat, provides, dog, training, in, Eugene, Oregon}
      7.{Dog, and, cat, is, a, slang, term, used, by, police, officers, for, a, malefemale, relationship}
      8.{Shop, for, your, show, dog, grooming, and, pet, supplies}
      위와 같이 8개의 basket에 item 들이 word 로 존재할떄 해당 3이상의 frequent 아이템들을 찾아보자 
      singleton sets
      cat 7
      and  5
      dog 7
      training 3
      a 3
      다른 단어들은 2 이하임으로 제외
      dubleton을 찾아보자 싱글톤인 애들의 조합만이 더블톤이 될 가능성이 있음으로 
        training    a        and        cat
      dog    4,6            2,3,7    1,2,8    1,2,3,6,7
      cat    5,6            2,3,7    1,2,5
      and 5            2,7
      a    none
      위의 조합 표를 보면 
      {dog,a}        3
      {dog,and}    3
      {dog,cat}    5
      {cat,a}        3
      {cat,and}    3
      triple 을 찾아보면 doubleton 조합중에서 아래의 2조합만 가능하며 실제로 카운팅해보면
      {dog, cat, and}    2
      {dog, cat, a}    3
      {dog, cat, a}만이  trpiple 임을 알수 있다.
      

  1. 6.1.2 Application of Frequent Itemsets
    실재로 frequent itemsets는 월마트 등에서 유저가 쇼핑카드에 물건을 담아 사가는 것을 분석하는대서 시작했다.
    목적은 마케팅에 있다 예를 들어 맥주와 기저기과 함께 팔린다고 하자 이유는 집에 아기가 있으면 외출 할수 없기 때문에 맥주를 사간다 라는 가정이 성립된다. 그러면 기저기를 싸게 팔고 맥주값을 올린다면? 소비자는 싸게 기저기를 사서 좋고 마트는(맥주 값을 올렸기 떄문에 기저기 값을 내린 손해가 없다) 물건을 많이 팔아서 좋다. 유일하게 경쟁 마트만 손해를 본다.
    • 해당 알고리즘을 다른곳에 응용할수 있다.
    1. related concepts
      item == word, basket == document 라고 하고 stop words 를 제거 하고 자주 나오는 단어 셋을 찾아본다면 새로운 정보를 습득할수 있다. 예를 들어 트위터 메세지 에서 정말 잘 안나오는 단어인{Brad, Angelina}가 같이 나온다면 어떠한 연관 관계가 생겼다는걸 추측 할 수 있다.
    2. Plagiarism
      item == documents, basket == sentacnes 이라고 해보자
      문서는 문장으로 이루어져 있다. 만약 여러문서에서 동일한 문장이 자주 나온다면 해당 문서는 표절 문서라고 추측 할수 있다.
      items
      doc1 = {
       "hello me",
       "nice to meet you",
       "origin words"
      }
      copydoc1 = {
       "hello me",
       "nice to meet you",
       "change words"
      }
      basket
      basket1 = {
       "hello me",
       "nice to meet you",
       "origin words"
      }
      basket2 = {
       "hello me",
       "nice to meet you",
       "change words"
      }
      {"hello me", "nice to meet you"}is frequent item
      
      item 과 basket 의 관계는 다대다관계일뿐 어느 하나가 다른 하나에 완전이 포함되지 않아도 된다.
    3. Biomarkers
      item 이 두종류로 구성되어 있다.
      item == (유전적 특징 또는 피의 단백질 구조로 특징을 나타낼수있는것) 또는 질병, basket == 환자 데이터
      만약 여러 특징이 동일한 질병과 자주 frequent item set 을 이룬다면 해당 특징이 질병을 유발할수 있다고 추측 할수 있다.

  1. 6.1.3 Association Rules
    I \rightarrow j 는 I set 이 있다면 j 아이템이 같이 존재할 가능성이 높다는것이다.
    그렇다면 그 가능성은 어떻게 표현할까?
    confidence == \frac{I\bigcup \{j\}}{I}
     ex2) ex1 을 생각해보자 {cat,dog} -> and 라는 연관 규측의 confidence 를 구해보자
     {cat,dog}은 1,2,3,6,7에 존재하고 {cat,dog,and}는 1,2,7 에 존재한다. 즉 confidence 는 3/5 이다.
    
    연관도를 측정하는대에는 interest 라는 개념도 필요하다
    interest == \frac{I\bigcup \{j\}}{I} - \frac{\{j\}}{\{\phi\}}
    위의 식에서 \frac{\{j\}}{\{\phi\}}는 {j}가 있는 바스켓의 수, \{\phi\}은 전체 바스켓의수
    만약 양의 관계라면 증가할꺼고 음의 관계라면 감소할꺼다
    예를 들면 콜라를 사면 팹시를 사지 않을것이다.
     ex3){dog}-> cat confidence = 5/7 {}->cat 6/8(전체 8개에서 6번 나옴)
     interest == -0.036 == 0
     {cat}->kitten 
     interest =0.042 == 0
    
    interest 가 둘다 너무 낮기 떄문에 둘다 의미가 없다.

  1. 6.1.4 Finding Association Rules with High Confidence
    실제 오프라인 마켓에서 support 는 1% confience 는 50%이상으로 잡아야만 효과가 있다.
    I\bigcup \{j\}는 충분이 높은 support를 가지고 있다.
    너무 많은 frequent itemset 이 발견된다면 s를 높여서 수를 조정하

  1. 6.2 Market Baskets and the A-Priori Alogrithm
    자 이제 기본적인 A-Priori Algorithm 을 확인하고 그후 발전된 방법에 대해서 이야기해보자

  1. 6.2.1 Representation of Marekt-Basket Data
    일단 바스켓 데이터는 파일에 바스켓 별로 저장되어 있다고 하자
     {23,456,1001}-{3,18,92,145}....
    
    일단 하나의 서버에서만 생각을 해보자 (뒤에가면 병렬서버 알고리즘 나옴)
    바스켓 파일의 양은 메인 메모리에 무조건 맞지 않고
    만약 아이템 쌍의 수가 매인 메모리에 맞을 정도로 작다고 가정하면 아이탬이 20 개일 경우
    20C2 로 구할수 있다.
    만약 아이탬이 크거나 쌍의 크기가 k로 증가한다면 문제가 생긴다.
    하지만 알고리즘에의해 해결 할수 있음으로 실제적으로 알고리즘의 속도는 바스켓 파일을 블락단위로 메모리에 읽는 시간으로 측정 할 수 있다. 또한 모든 알고리즘은 바스켓파일을 순차적으로 읽기 때문에 알고리즘의 속도는 파일 전체를 몇번 읽느냐로 측정하자(우리는 바스켓 파일의 크기를 조정 할수 없다)

  1. 6.2.2 Use of Main Memory for Itemset Counting
    일단 우리가 셀려고 하는 숫자가 메인 메모리에 맞지 않는다면 디스크 IO가 발생하고 알고리즘은 느려진다.
    그러므로 우리는 메모리에 맞지 않는 데이터는 처리 할 수 없다고 가정하자
     ex)6.5 어떤 알고리즘이 아이템 쌍의 숫자를 센대고 생각해보자 그러면 우리는 nC2의 integer 를 저장할 공간이 필요하다. 쌍의 수를 약  n^2/2 라고 하고 integer 를 4 byte 라고 한다면 우리는 2n^2 byte 가 필요하다는걸 알 수 있다. 만약 메모리가 2G(2^31)이라고 한다면 n<2^15 임으로 n은 약33,000 개까지 가능하다는걸 알 수 있다.
    
    결국 메모리 사용량이 중요함으로 아이템이 “bread” 처럼 들어가 있을 경우 해쉬 테이블을 만들어 integer 에 mapping 하자
     1,bread
     2,cat
     3,aa
    
    • The Triangular-Matrix Method
      저장 공간을 삼각 벡터에 저장한다고 생각하면 공간 낭비가 됨으로 (대각선의 반이 낭비됨) (2차원 메트릭스에 저장할때) 즉 {i,j}이고 1 <= j <= i <= n이 성립할때
      k = (i - 1)(n - \frac{i}{2}) + j -i
      1차원 배열에 저장할수 있다 k 가 배열 인덱스
    • The Triples Method
      i < j 일때 우리는 [i,j,c]로 저장할수있다. 해당 구조는 i,j 를 키로 한 해쉬 테이블로 만들경우 쉽게 검색 할수있다. 위의 삼각 메트릭스 저장보다 좋은건 0을 저장하지 않아도 된다는것이다.
      즉 nC2 * 1/3 보다 0을 가진 페어의 수가 많다면 Triangular-Matrix 아니면 Triples Method를 사용하는게 저장 공간 효율에 더 좋다.
      ex6.6) 10^5 개의 아이템이 존재하고 10^7개의 바스켓이 존재하고 각각의 바스켓에 10개의 아이템이 존재한다고 가정해보자 이때 triangular-matrix method 의 경우 10^5C2 = 5 * 10^9 개의 integer 숫자를 저장할 공간이 필요하다 하지만 바스켓에 존재하는 모든 페어의 개수는 10^7(10C2)임으로 = 10^7 * 10 * 9 / 2 = 10^8 * 4.5 임을 알수 있다. 극단적으로 4.5 * 10^8이 모두 0이 아 아니라고 Triples Method 를 사용한다고 하고 해당 개수에 3(i,j,c)을 곱하면 4.5 * 3 * 10^8  = 1.5  * 10^9 의 저장공간이 필요하다  이와 같은 경우 어떠한 경우에도 Triples Method 가 유리함을 알 수 있다.
      

  1. 6.2.3 Monotonicity of Itemsets
    만약 아이템 셋 I 가 frequent item 이되려면 모든 I의 subset은 frequent item 이어야한다.
    이유는 간단하다 J\subseteq I이라면 I를 포함한 모든 바스켓은 반드시 J를 포함해야한다.
    즉 J 의 횟수는 I 보다 크거나 같다. 또한 I가 support thread hold s 보다 높다면 J도 높다.
    또한 J는 I - J 에서 하나 두개의 element 가 빠진 바스켓에 포함 될수 있다. 위의 상황을 생각하면 J는 I 보다 크다.
     A = {a,b,c,d,e}
     B = {a,b,c,q}
     C = {a,b,c,d,z}
     I = {a,b,c,d}
     J = {a,b,c}
     S = 2 일때 
     B의 경우 I - j = {d} 를 빼고 J를 포함하는 바스켓의 예이다.
    
    또한 maximal 이라는 개념을 보자 만약 특정 support s를 주어준다면 우리는 해당 아이템셋을 포함한 어떠한 슈퍼 셋도 없을때 그 아이템셋을 maximal 이라고 할 수 있다. 우리가 모든 maximal itemset을 리스트 한다면 maximal list의 모든 subset itemsets들은 frequent 이고 maximal item set의 subset 이 아닌 모든 item set들은 frequent 하지 않음을 알수있다.
     ex)6.7
     ex)6.1 을 보면 s = 3
     singleton : {cat},{dog},{a},{and},{traing}
     doubleton : {dog,a},{dog,and},{dog,cat},{cat,a},{cat,and}
     triple    : {dog,cat,a}
     싱글톤을 보면 traing 을 포함한 더블톤이 존재하지 않는다 그럼으로 maximal 의 정의에 의해 traing은 maximal 이다.
     트리플을 보면 and 를 포함하지 않느다 즉 {dog,and},{cat,and}은 maximal 이다.
     또한 {dog,cat,a} 는 maximal 이다.
    

  1. 6.2.4 Tyranny of Counting Pairs
    지금까지 우리는 쌍을 세는대 집중해 왔다 왜 그랬을까? 아이템 수가 아무리 많아도 싱글톤을 세는대 문제가 발생하는 경우는 희귀할 것이다. 물론 tripte,quadruples 를 셀때 문제가 발생 할 수 있다. 하지만 monotonicity를 사용하면 뒤로 갈수록 조합은 줄어든다.
    예를 들어 쌍의 경우에도 최초 가정인 support s 가 충분이 높다면 문제가 될게 없다.
    (싱글톤 중 support s를 만족하는 수가 작기 때문에 통과한 itemset 끼리의 조합도 적다.)

  1. 6.2.5 The A-Priori Algorithm
    자 이제 쌍을 세는대 집중해보자 만약 우리가 모든쌍을 메모리에 셀수 있을정도의 메모리가 가능하다면(triangular matrix or triple) 문제는 쉽다. 바스켓 파일을 처음부터 끝까지 읽어 내려가면서 모든 바스켓에서 루프를 두번 돌면서 모든 쌍에 대해서 카운트를 넣어주면 된다. 그후 모든 쌍에 대해서 s를 넘는 쌍을 구하면 끝이다.
    하지만 쌍이 너무 많아서 메모리에 들어갈수 없다면 어떻게 될까? 이때 해결책으로 A-priori 알고리즘이 나온다. 기본 아이디어는 카운트 하는 아이템의 숫자를 줄인다. 단 위에서처럼 한번의 리드가 아닌 2번의 리드로 처리한다.(그래도 랜덤 엑세스에 비교하면 엄청 낮은 코스트를 가진다.)
    • The First Pass of A-Priori
      두개의 테이블을 만든다. 1번 테이블은 (만약 필요하다면) name 을 integer 로 맵핑하는 테이블이다.
      1,bread
      2,cat food
      3,dog food
      4,toy
      
      2번 테이블은 1차원 배열로 해당 아이템의 인덱스에 카운트를 넣기 위해 준비한다. 최초 모든 카운트는 0이다.
      우리는 바스켓 파일을 읽으면서 아이템 이름을 index 로 변환후 해당 인덱스에 +1 을 한다.
    • Between the Passes of A-Priori
      2번 테이블에서 support threshold s 보다 큰 아이템을 골라 낸다면 threshold 자체가 1%를 넘기 떄문에 많은 아이템들이 없어진다. 메모리 공간의 효율성을 위해서 좀전에 만든 1번 테이블을 다시 만든다.
      (이전 테이블 1~n, 이후 테이블 1~m)
      //2,4번이 s 보다 클경우
      1,cat food
      2,toy
      
    • The Second Pass of A-Priori
      모든 아이템 m 에대해서 쌍을 만든다. 필요한 공간은 2n^2 이 아니라 2m^2 이다. 또는 Triples Method를 사용할수도 있다.
      1.각각의 바스켓에서 frequent item을 뽑아 낸다.
      2.뽑아낸 item을 이중 루프를 돌면서 가능한 모든쌍을 만든다.
      3.모든 쌍에 대해서 카운트 데이터 구조에 +1 을 한다.
      
      마지막에 thread hold s 보다 큰 item set을 골라낸다.

  1. 6.2.6 A-Priori for All Frequent Itemsets
    만약 해당 k가 하나도 존재하지 않는다면 monotonicity 속성이 이보다큰 freqeunt set이 존재 하지 않음을 알려줌으로 stop 할 수 있다.
    그렇지 않다면 k 에서 k+1 로 갈떄 아래의 순서를 실행한다.
     1.$C_k$ k의 가능한 모든 아이템 조합들의 셋 (실제로 frequent item임을 확인하기 위해서는 카운팅 해야함)
     2.$L_k$ k의 사이중에서 실제로 freqeunt time set들의  set
    
    위 순서를 생각하면
    C1 -> filter -> L1 -> construct -> C2 -> filter -> L2 -> construct -> C3 ….
    C1의 경우 singleton을 찾는 작업이다. 모든 아이템에 대해서 C1을 만들고 카운팅한다. filter 에서 s가 안되는 애들을 빼내면 L1 singleton 이 나온다.
    L1 을 가지고 가능한 모든 조합을 카운팅할수 있는 C2를 정의하고 실제로 카운팅을 한다.
    (이때문터는 Triples Method가 더유리하기 떄문에 카운팅 할때 C2에 집어넣는다.)
    C2에서 s가 넘는 애들을 빼면 L2 doubltone 이 나온다.
    C3의 경우 L2의 모든 조합을 가지고 C3를 정의하고 실제로 카운팅을 한다.카운팅할떄 L2에 존재하는 애들만 조합으로 만든다.
    C3에서 s를 비교해 큰애들로 L3를 만든다.
    원하는 만큼 반복할수 있다.
    알고리즘을 요약하면 아래와 같다.
    1.C_k를 정의한다 k는 아이템 셋의 사이즈이고 모든 k-1은 L_k에 존재한다.
    2.실제로 바스켓을 읽어 드리며 C_K에 존재하는 셋을 카운트해서 L_k를 찾는다.
    3.s 가 크다면 해당 아이템은 L_k에 존재하게 된다.
     ex)6.8
     모든 아이템이 1~10의 숫자로 이루어져 있고 1~5까지가 singleton이라고 하자
     또한 {1,2},{2,3},{3,4},{4,5}만이 더블톤이고 {2,3,4} 트리플일때 
     알고리즘을 돌리자 최초 C1에는 1~10까지 의 모든 숫자가 있고 싱글톤은 1~5라고 했으니 L1은 1~5이다.
     L1의 모든 조합을 가지고 있는 셋을 C2라고 정의하자 바켓을 읽으면서 L1에 존재하는 조합들만 카운팅을 하면 C2의 조합중 {1,2},{2,3},{3,4},{4,5}이 더블톤임을 할수 있고 해당 셋이 L2이다.
     L2를 가지고 C3를 정의하고 바켓을 읽으면서 L2에 존재하는 조합들만 카운트 하면 {2,3,4}만이 트리플임을 알수 있다.
    

원본책  http://www.mmds.org